
主張:能跟使用者對話只是 agent 能力的一半,另一半是它能不能在沒有人類盯著的時候,自己對世界的變化做出反應,並且在斷電、逾時、使用者反悔的時候優雅收場。
讀完能做到:讓 agent 對 Pub/Sub、Eventarc 事件自動反應,看懂 Runner 跟你的程式碼之間 yield/pause/resume 的真正意義,並知道 Resume 跟 Cancel 這兩個聽起來很像的功能,其實是完全不同的兩件事。
前三天的 agent 都需要一個真人在線上跟它互動——講話、看鏡頭、打斷它。但很多真實世界的 agent 工作根本不需要人類在場:凌晨三點有人上傳了一份文件到 Cloud Storage,需要有東西去分類它;資料庫寫入一筆異常交易,需要有東西去標記它;每天早上八點,需要有東西自動生成一份報表。今天要講的 Ambient Agents(Python v1.29.0 / Go v1.1.0),就是為了這類「沒人盯著」的場景設計的。
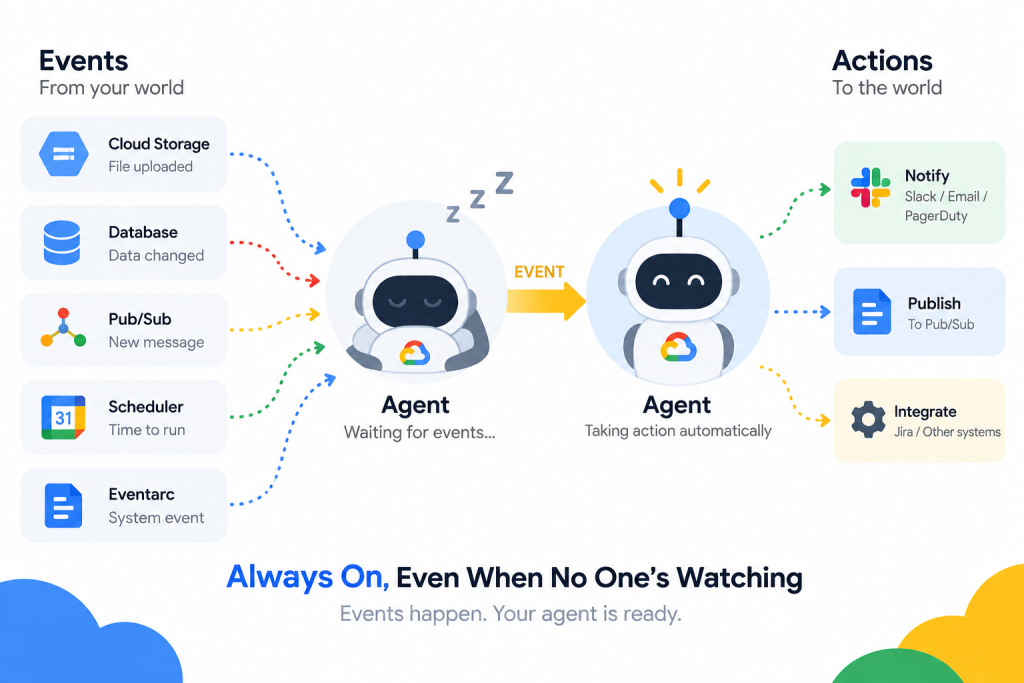
官方定義很直接:當你想讓 agent 對事件或新資料做出反應,而不是等人類輸入,你就設定觸發器(trigger),讓它變成 ambient agent——以背景程序的形式運行,處理資料、監控事件、非同步回應,完全不需要人介入。典型場景包含回應雲端事件(檔案上傳到 Cloud Storage、資料庫變更、審計日誌條目)、處理佇列訊息(分析進來的客服單、內容審核、文件分類)、排程執行(每日報表、週期性監控檢查、批次作業),以及監控基礎設施(對持續不斷的事件流做出自動反應)。
因為沒有人在場等回覆,ambient agent 的輸出必須路由到某個通知管道——結構化日誌搭配 Cloud Monitoring 告警(轉發到 Email/Slack/PagerDuty)、發佈到 Pub/Sub 主題讓下游服務消費,或用 Application Integration 轉發到 Email、Jira 等系統。
ADK 提供兩種做法,官方用一張表講清楚取捨:
/run 端點 |
Trigger 端點 | |
|---|---|---|
| 事件來源 | 任何(Pub/Sub、webhook、cron、自訂服務) | Cloud Pub/Sub、Eventarc(Standard 與 Advanced) |
| Payload 解析 | 你自己處理 | 自動(Base64 解碼、CloudEvent 解析) |
| Session 建立 | 需啟用 --auto_create_session |
自動(每個事件一個) |
| 併發控制 | 你自己處理 | 內建 semaphore,可設上限 |
| 重試邏輯 | 你自己處理 | 指數退避+抖動,自動處理暫時性錯誤 |
| 最適合 | 自訂整合、非 GCP 來源 | GCP 原生事件驅動工作負載 |
用 /run 的時機,是你要完全掌控整合細節,或事件來源不是 GCP。啟用自動建立 session:
adk api_server --auto_create_session path/to/your/agent
任何能發 HTTP 請求的來源都能接上,例如一個接收 GitHub webhook 並轉發給 agent 的 Cloud Run function。
用 Trigger 端點,則是當事件來源是 Pub/Sub 或 Eventarc,想讓 ADK 幫你把 payload 解析、session 建立、併發控制、重試邏輯全部處理掉。啟用方式是加旗標:
adk api_server --trigger_sources "pubsub,eventarc" path/to/your/agent
一個處理 trigger 事件的 agent 範例:
import json

from google.adk.agents import LlmAgent


def parse_event(raw_event: str) -> dict:
    """Parse and extract structured data from a trigger event.

    Trigger endpoints deliver events as a JSON string with 'data' and
    'attributes' fields. This tool extracts those fields so the agent
    can reason about the event contents.
    """
    try:
        event = json.loads(raw_event)
    except json.JSONDecodeError as e:
        return {"error": f"Failed to parse event JSON: {e}"}
    return {
        "data": event.get("data"),
        "attributes": event.get("attributes", {}),
    }


root_agent = LlmAgent(
    model="gemini-flash-latest",
    name="event_processor",
    instruction="""You are an event-processing agent that handles incoming
events from Pub/Sub and Eventarc triggers.

When you receive an event:
1. Use the `parse_event` tool to extract the event data and attributes.
2. Analyze the event contents and determine what action to take.
3. Summarize what you found and what action you would recommend.

Be concise and structured in your responses.""",
    tools=[parse_event],
)
測試用 curl 送一筆模擬事件:
curl -X POST http://localhost:8000/apps/event_processing_agent/trigger/pubsub \
  -H "Content-Type: application/json" \
  -d '{
    "message": {
      "data": "eyJvcmRlcl9pZCI6ICIxMjM0IiwgInN0YXR1cyI6ICJuZXcifQ==",
      "attributes": {"source": "orders-service"}
    },
    "subscription": "projects/my-project/subscriptions/orders-sub"
  }'
Base64 那串解碼後是 {"order_id": "1234", "status": "new"}——trigger 端點自動幫你解碼,你的 agent 直接拿到結構化資料。
逾時 10 分鐘:所有 trigger 端點都是同步處理,等 agent 跑完才回應——這是刻意設計,保持 HTTP 請求存活能防止託管基礎設施在 agent 還在工作時把程序砍掉,而且同步的成功/失敗回應碼(200/500)正是 Pub/Sub、Eventarc 判斷要不要重試的依據。上游服務(Pub/Sub push 或 Eventarc)的最大逾時都是 10 分鐘。如果你的 agent 工作會超過這個時間,trigger 端點不適合你,該換成 Pub/Sub pull 訂閱、Cloud Run Jobs,或 worker pool 架構。
還有一條更徹底的路:往下一層,換掉整個執行模型。Temporal、Restate、Dapr 這三個第三方耐久執行引擎,把每次 LLM 呼叫與工具呼叫都變成可以跨 process 崩潰恢復的 activity,暫停時間量級可以拉到數天甚至數週,不再受 10 分鐘束縛。細節見官方文件的 Temporal、Restate、Dapr 整合頁。
併發與重試是 per-process 的,拆成幾點看更清楚:
ADK_TRIGGER_MAX_CONCURRENT 環境變數或 --trigger_max_concurrent_runs 旗標),超過就排隊等空位。429 RESOURCE_EXHAUSTED)預設重試 3 次,指數退避+抖動,基礎延遲 1 秒、最大延遲 30 秒,全部可調。(順帶一提:今天講的是 agent 被 Pub/Sub/Eventarc 觸發的方向;反過來,agent 主動發送 Pub/Sub 訊息或 Eventarc CloudEvents,是另外兩個獨立的工具——PubSubToolset、EventarcToolset,細節見官方文件的 Pub/Sub integration 與 Eventarc integration,兩個方向合起來才是完整的事件驅動架構。)
講完了怎麼觸發 agent,現在往下一層——agent 內部到底是怎麼運作的。ADK Runtime 的核心是一個 Event Loop,Runner 跟你的 Execution Logic(Agent、Tool、Callback)之間透過 yield/pause/resume 的循環溝通:
Runner 收到使用者查詢,呼叫主 Agent 開始處理Agent 跑到有東西要回報的時候(一則回應、一個工具呼叫請求、一次狀態變更)——它 yield 一個 Event
Runner 收到這個 Event,處理相關動作(透過 Services 存狀態變更),然後把事件往上游轉發Runner 處理完這個事件之後,Agent 的邏輯才會恢復,並且能可靠地看到 Runner 剛剛提交的變更第 4 點是整個機制裡最重要、也最容易被忽略的一句話:狀態變更只有在事件被 yield 且被 Runner 處理過之後才保證被持久化。
# Inside agent logic(概念示意)

# 1. 修改狀態
ctx.session.state['status'] = 'processing'
event1 = Event(..., actions=EventActions(state_delta={'status': 'processing'}))

# 2. Yield 帶著 delta 的事件
yield event1
# --- 暫停 --- Runner 處理 event1,SessionService 提交 'status' = 'processing' ---

# 3. 恢復執行
# 現在可以安全依賴已提交的狀態
current_status = ctx.session.state['status']  # 保證是 'processing'
print(f"Status after resuming: {current_status}")
這解釋了一個你可能已經在 Day 12 的 Callbacks 學習中隱約感覺到、但沒點破的規則:你在 callback 或 tool 裡改的 state,要等到帶著那個 state_delta 的事件被 yield 並被 Runner 處理過,才算真正落地。
同一個 invocation 裡,yield 之前改的 state,後面的程式碼通常還是讀得到——這叫「dirty read」:
# Code in before_agent_callback
callback_context.state['field_1'] = 'value_1'
# 狀態本地已設為 'value_1',但 Runner 還沒提交

# ... agent 執行 ...

# 同一個 invocation 裡,稍後被呼叫的 tool 中的程式碼
# 可讀取(dirty read),但 'value_1' 尚未保證持久化
val = tool_context.state['field_1']  # 這裡的 val 大機率是 'value_1'
這個機制的好處是讓同一個複雜步驟裡的多個 callback 或工具呼叫能互相協調,不用每次都走完整的 yield/commit 循環。但代價很現實:如果在帶著那個 state_delta 的事件被 yield 並處理之前,整個 invocation 失敗了,這個未提交的狀態變更就會遺失。對關鍵的狀態轉移,不要單純依賴 dirty read,要確保它跟一個真的成功被處理的事件綁在一起。
這個機制也解釋了串流輸出為什麼要分兩種事件處理:LLM 逐字生成回應時,框架會 yield 多個標記 partial=True 的事件——Runner 收到這種事件會立即往上游轉發(讓 UI 即時顯示),但跳過處理它的 actions(不提交 state_delta)。直到框架 yield 最後一個非 partial 的事件,Runner 才會完整處理它,提交相關的狀態變更。這確保狀態變更是基於 LLM完整回應原子性地套用,同時 UI 還能逐步顯示生成中的文字。
搞懂了 Event Loop,Resume(Python v1.16.0 / Kotlin)功能就好理解了——它靠紀錄已完成的 workflow 步驟(透過 Events 與 Event Actions)來追蹤進度,中斷後重啟時,系統依每個 agent 的完成狀態決定要不要重跑。
前面 event_processing_agent 那個例子,CLI 直接吃一個裸的 root_agent 就能跑;想開 Resume,得先把它包進一個 App 物件——App 是 root_agent 的一層包裝,用來掛 resumability 這類跨整個應用生效的設定,adk api_server 兩種寫法都認得。啟用方式是在 App 上加 resumability 設定:
from google.adk.agents import LlmAgent
from google.adk.apps import App, ResumabilityConfig

root_agent = LlmAgent(
    model='gemini-flash-latest',
    name='my_resumable_agent',
    instruction='You are a helpful assistant that completes multi-step tasks.',
)

app = App(
    name='my_resumable_agent',
    root_agent=root_agent,
    resumability_config=ResumabilityConfig(
        is_resumable=True,
    ),
)
恢復一個中斷的 workflow,靠的是 Event 歷史裡的 Invocation ID。session_id、invocation_id 不是隨便填的字串——必須是一次真的執行過、且被中斷的 invocation 留下的值,從那次呼叫的回傳事件或 session 的 Event 歷史裡取得,下面這組值只是示意欄位長什麼樣子:
adk api_server my_resumable_agent/
curl -X POST http://localhost:8000/run_sse \
 -H "Content-Type: application/json" \
 -d '{
   "app_name": "my_resumable_agent",
   "user_id": "u_123",
   "session_id": "s_abc",
   "invocation_id": "invocation-123"
 }'
注意:ADK Web 介面跟 CLI 目前都不支援從介面上恢復 workflow,只能透過 API 呼叫。而且這段語法示範的是「怎麼呼叫」,不是「怎麼觀察差異」——對著一個乾淨、沒被打斷過的 invocation 重打這支 curl,不會有任何訊息告訴你「這是接續執行」,真正的差異只會體現在行為上:已經完成的 sub-agent 不會被重新呼叫。下一段就是三種 workflow agent 各自怎麼判斷該跳過哪些步驟。
不同 workflow agent 類型的恢復行為不一樣——Sequential Agent 從已存的 current_sub_agent 找下一個該跑的 sub-agent;Loop Agent 用 current_sub_agent 跟 times_looped 從上次完成的迭代接續;Parallel Agent 判斷哪些 sub-agent 已完成,只跑還沒完成的那些。
三則警語,建置前一定要讀:
如果你用的是 Custom Agent,預設不支援 Resume,需要自己實作:定義一個繼承 BaseAgentState 的狀態類別記錄目前跑到哪一步、在每個完成的步驟存 checkpoint、最後在完成時標記 end_of_agent=True。官方文件給的完整範例是把 Day 18 提過的 StoryFlowAgent(critic-reviser 循環)改造成可恢復版本,核心模式是每個階段開始前先檢查 next_step,跳過已完成的部分。
看到 Resume 跟 Cancel 放在同一天,很容易誤會兩者是一組對稱功能——不是。Resume 是「中斷後接回去繼續跑」,Cancel 是「主動喊停,已完成的部分保留」。而且支援語言完全不重疊:
🚨 Cancel 目前僅 TypeScript v1.0.0 支援,用的是標準的 AbortController / AbortSignal 模式,取消訊號會往下傳播到整個執行堆疊(Runner、LlmAgent、LoopAgent、工具呼叫都能在各自的關鍵點中止),行為是優雅的:已 yield 的事件保留在 session 歷史裡,進行中的則被丟棄。完整程式碼與細節見官方文件 Cancel agent runs。
如果你的專案是 Python,現階段沒有對等的 Cancel API——只能靠 Resume 搭配你自己的邏輯(例如逾時後主動結束 session)去模擬類似的「喊停」效果。
今天把「沒人盯著的時候」拆成了三塊:Ambient Agents 讓 agent 對外部事件自動反應,Event Loop 解釋了 yield/pause/resume 這個貫穿整個 ADK Runtime 的核心機制,Resume 跟 Cancel 則是中斷恢復與主動終止這兩種完全不同的容錯手段。明天要看的是另一個省 context 的機制——Agent Skills,以及它背後正在成形的生態系統。
Google ADK 官方網站
GitHub - Agent Development Kit (ADK) 2.0
GitHub 開源實作:https://github.com/SeanLinH/adk_tutor


 iThome鐵人賽
 看影片追技術